Как подключить двух провайдеров к одному роутеру Zyxel?
Два провайдера в один роутер подключают для резервирования внешнего канала, распределения нагрузки или сочетания этих задач. Failover переключает доступ при отказе основного пути, а балансировка распределяет подходящие соединения между каналами. Ни один режим не гарантирует сохранение всех существующих сессий при смене публичного адреса.
Хороший проект определяет, что считать отказом, куда направлять критичные приложения и как возвращаться к основному провайдеру. Просто подключить второй кабель недостаточно: шлюз может видеть активный Ethernet-порт, хотя интернет за ним уже недоступен.
Чем failover отличается от балансировки?
В схеме основной/резерв трафик обычно идёт по выбранному главному каналу, пока он соответствует заданным условиям. При отказе новые соединения переходят на резерв. Такая схема удобна для ограниченного или тарифицируемого мобильного канала, который не хочется использовать постоянно.
Балансировка может распределять разные соединения между провайдерами. Но один обычный поток часто использует один путь. Каналы 100 и 200 Мбит/с не становятся автоматически линией 300 Мбит/с для одного скачивания. Алгоритм распределения и требования приложения нужно проверить у конкретного шлюза.
| Режим | Основная цель | Что проверить |
|---|---|---|
| Основной/резерв | Продолжение доступа после отказа | Детектор отказа и новые сессии |
| Балансировка | Распределение разных соединений | Алгоритм, вес каналов, привязка приложений |
| Политики по приложениям | Предсказуемый путь критичного сервиса | Правила и поведение при недоступности |
| LTE как резерв | Быстрое восстановление внешнего доступа | Покрытие, лимит трафика, NAT и VPN |
Как различаются Weighted Round Robin, Least Load First и Spillover?
В поддерживаемом WAN Trunk Weighted Round Robin распределяет новые сессии по весам; Least Load First учитывает выбранную текущую загрузку; Spillover использует следующий путь при предусмотренном достижении порога основного. Это разные способы выбора пути, а не разные обещания сложения скорости одной передачи. Фактические возможности и параметры подтверждают в выбранной модели и режиме.
Для условных каналов 200 и 100 Мбит/с веса 2:1 дают первому больше назначений новых сессий. Но три сессии могут иметь совершенно разный объём; распределение их количества не гарантирует точные 200 и 100 Мбит/с в каждую секунду. Крупный поток способен занять один путь, пока другой менее загружен. Результат проверяют на реальном составе приложений.
| Цель проекта | Что сравнить | Что испытать |
|---|---|---|
| Основной канал и аварийный резерв | Приоритет и проверку доступности | Полный и внешний отказ основного |
| Одновременную работу нескольких приложений | Веса и нагрузочную политику | Несколько потоков разного размера |
| Экономию платного мобильного трафика | Резервный режим или поддерживаемый Spillover | Порог и работу при отказе |
| Сохранение пути важной сессии | Поддерживаемые правила закрепления | Новую и уже работающую сессии |
Скорости загрузки и отдачи могут иметь разные соотношения. Каналы 200/50 и 100/100 Мбит/с различаются не только общей крупной цифрой. Если проект важен для исходящего видео, учитывайте именно отдачу и нужный индекс загрузки. Неправильные значения полосы в конфигурации способны исказить выбор пути.
Как убедиться, что провайдеры независимы?
Проверьте не только договоры с разными компаниями, но и фактические трассы, вводы здания и общую инфраструктуру. Два канала могут использовать один повреждаемый участок или общий узел. Одновременно они также зависят от питания офисного шлюза и устройств доступа.
Полная независимость может быть дорогой, но общий риск должен быть понятен. Мобильный резерв уменьшает зависимость от некоторых кабельных трасс, однако зависит от покрытия, загрузки сети и питания. Не описывайте такую схему как гарантию интернета при любом происшествии.
Как доказать независимость провайдеров и закончить приёмку?
Уточните физическую трассу, оборудование внутри здания, общие места питания и внешние зависимости. Два договора могут использовать один ввод или общий участок. Резервирование провайдера и резервирование локального шлюза являются разными задачами. Проверяйте необходимые цепочки до точки, где завершает работу нужный сервис.
В программу включите отключение линии, внешний отказ при сохранённом link, краткий сбой, длительную работу резерва и возврат. Для каждого события сохраните время обнаружения, смену маршрута и восстановление приложений. Затем проверьте, что оба канала снова находятся в предусмотренном состоянии и мониторинг сообщает о потере резерва.
Для подбора Zyxel передайте параметры обоих подключений, обязательные сервисы, выбранный режим нагрузки и допустимый перерыв. Тогда запрос «два провайдера в один роутер» превращается в проверяемый проект доступности интернета и конкретный состав оборудования.
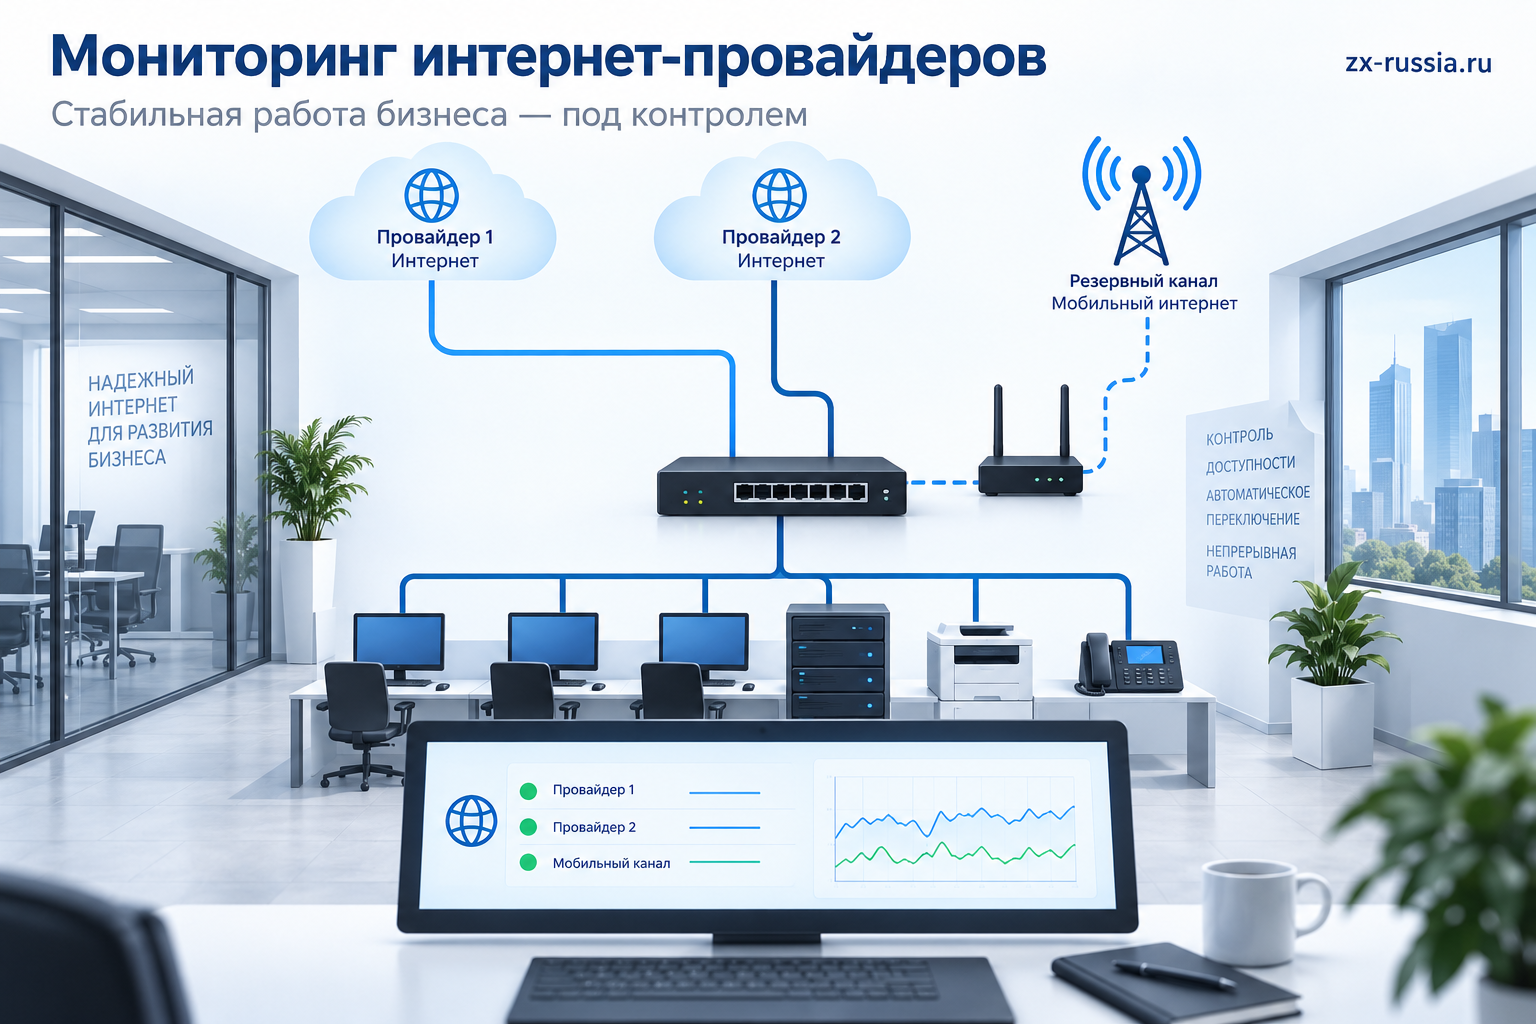
Как настроить проверку доступности?
Используйте поддерживаемую проверку не только состояния физического порта, но и прохождения трафика. Адрес проверки должен быть выбран осмысленно: единственный внешний сервер может перестать отвечать, хотя провайдер работает. Если шлюз поддерживает несколько проверок и правила оценки, задайте их под нужную задачу.
Слишком частые чувствительные проверки могут вызывать ложные переключения. Слишком редкие — увеличивать время реакции. Для учебного сценария проверка раз в 5 секунд с тремя последовательными неудачами даёт ориентир порядка 15 секунд обнаружения при определённом положении отказа относительно расписания. Это не обещание полного восстановления за 15 секунд: затем работают маршрутизация, VPN и клиентские приложения.
Почему физический link и доступность интернета проверяют отдельно?
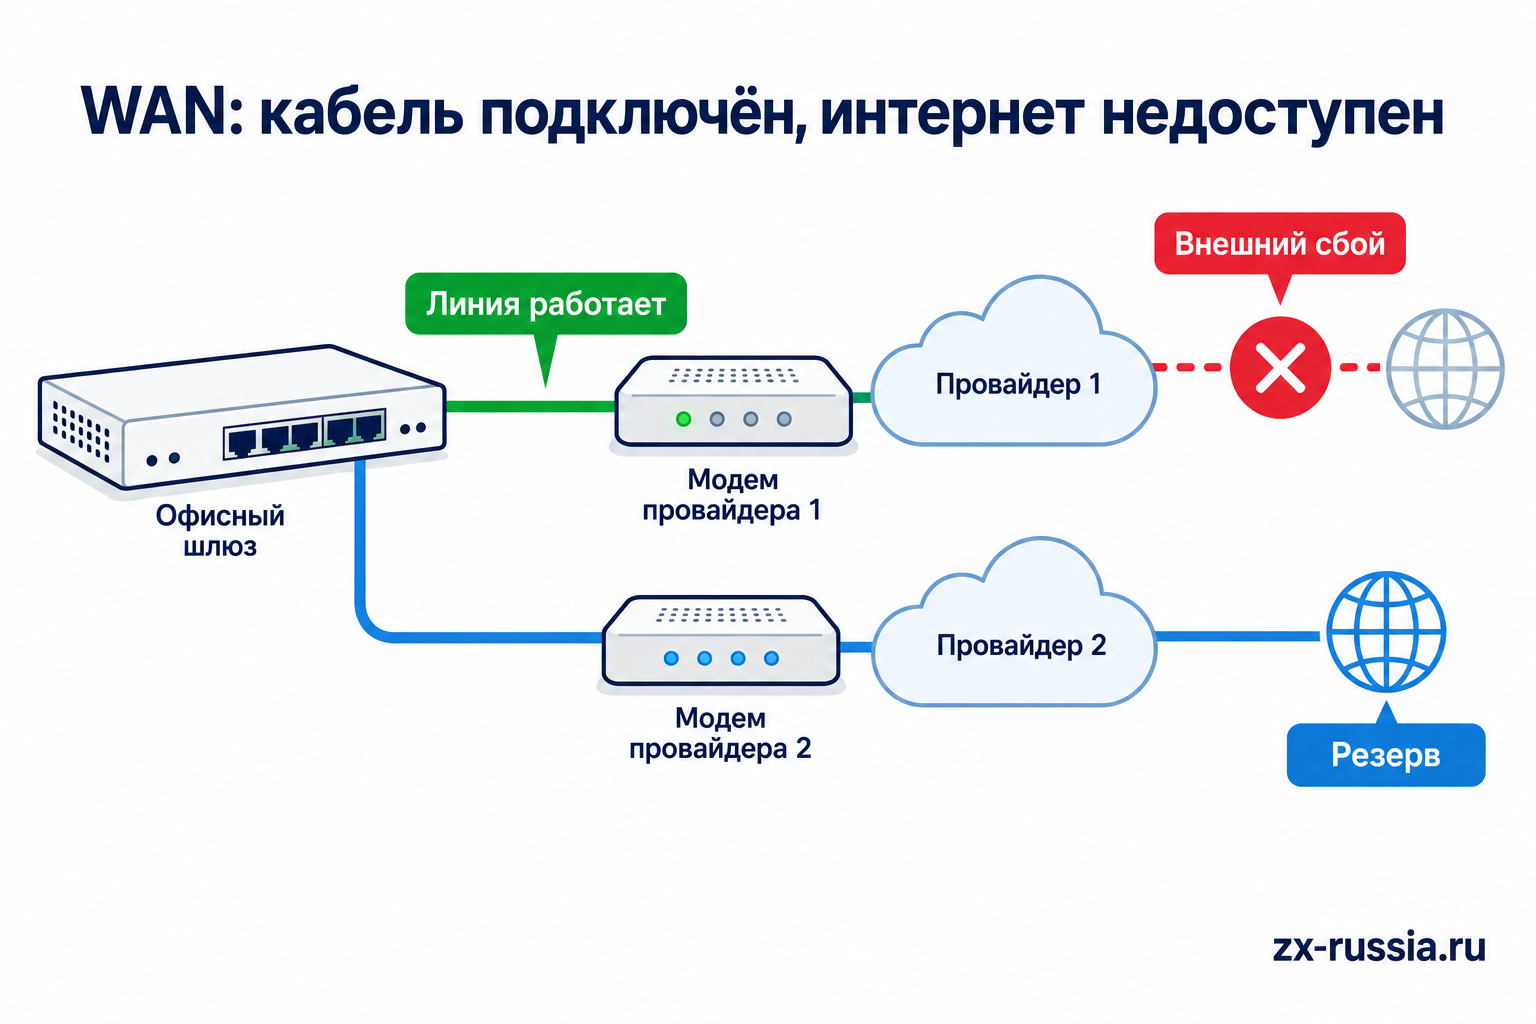
Кабель до оборудования провайдера может оставаться подключённым, когда внешний путь уже не работает. Шлюз видит Ethernet-link, но нужные ресурсы недоступны. Для автоматического переключения важна предусмотренная проверка за пределами физического соединения. Контроль одного состояния порта обнаруживает только часть отказов.
Connectivity Check на участниках WAN Trunk позволяет исследовать доступность внешних назначений в поддерживаемой схеме Zyxel. Проверка должна относиться к нужному интерфейсу: если её трафик уходит через другой работающий WAN, результат способен маскировать сбой проверяемого пути. При испытании сохраните источник, маршрут и фактическое назначение пробы.
Как выбрать адреса и логику проверки канала?
Задайте, что считается пригодным каналом для вашего бизнеса: общий интернет, доступность нужного приложения, DNS или сочетание условий. Одна доступная цель проверяет только путь к ней. Недоступность одной цели также может быть вызвана её собственным сбоем. Несколько целей помогают разделить эти случаи, если логика их оценки соответствует задаче.
Условие «достаточно одной успешной цели» и условие «должны ответить все» дают разное поведение. Первое способно оставить канал активным при частичной недоступности; второе способно переключить его из-за сбоя одной внешней цели. Настройки реализации и программа теста должны это учитывать. Для важных приложений дополнительно проверяют сам рабочий сервис, поскольку ICMP-ответ не подтверждает его работу.
Не включайте в список только следующий маршрутизатор провайдера, если задача — обнаружить отказ дальше в его сети. Но и произвольный внешний сайт не является надёжной универсальной контрольной точкой. Сохраните причины выбора целей и процедуру их пересмотра. Если требуется проверка имени, учтите зависимость самой проверки от DNS.
Как рассчитать время обнаружения отказа?
Рассмотрим упрощённую модель: проверки начинаются раз в пять секунд, отказ фиксируется после трёх последовательных неудач, таймаут ответа — две секунды. При независимом расписании стартов от события до первой проверки может пройти от нуля до пяти секунд. Затем между тремя попытками — десять секунд, последняя завершится после таймаута. Получается примерно 12–17 секунд обнаружения в этой модели.
Это не универсальное время failover: реализация может иначе планировать попытки, работать с несколькими целями и учитывать другие события. После обнаружения добавляются изменение маршрута, трансляции, установление VPN и восстановление приложения. Сумма этих этапов является тем временем, которое чувствует сотрудник. В журнале нужно разделить их, а не измерять только смену значка WAN.
Проверьте также краткий сбой короче принятого порога. Излишне чувствительная политика может вызывать переключения при единичной потере, а слишком медленная — долго сохранять непригодный путь. Интервалы выбирают по требуемому сервису и наблюдаемой среде. После изменения повторяют одинаковый сценарий отказа.
Что происходит с VPN, телефонией и банковскими сервисами?
При смене внешнего адреса удалённая сторона может перестать признавать текущую сессию. VPN способен потребовать новое установление туннеля, а звонок — прерваться. Приложения с привязкой к IP также нуждаются в проверке. В техническом задании разделите восстановление новых соединений и сохранение уже открытых.
Для критичного приложения можно задать привязку к предпочтительному WAN и поведение при его отказе. Но жёсткая привязка без резервного правила может оставить приложение недоступным, хотя второй канал исправен. Нужен понятный сценарий: переключить с допустимым повторным входом или ждать основного канала.
Почему существующая сессия может прерваться после failover?
При смене провайдера обычно меняется внешний путь и может измениться публичный адрес трансляции. Удалённая сторона видит другие параметры соединения. Приложению может понадобиться новое соединение, повторный вход или восстановление операции. Поддерживаемые механизмы отдельных протоколов способны менять поведение, но общий Multi-WAN не гарантирует сохранение любой сессии.
Проверьте браузер, телефонию, VPN, удалённый рабочий стол и важные внешние приложения отдельно. Одно короткое новое соединение после переключения не показывает судьбу старой долгой сессии. Некоторые приложения автоматически повторяют запрос, другие требуют действия пользователя. Приёмка должна сохранить допустимый порядок восстановления каждого критичного сервиса.
Для входящих сервисов смена провайдера создаёт дополнительную задачу адресации и доступности. Изменение исходящего маршрута не переносит автоматически опубликованный адрес сервера. Если такой сервис обязателен, включите в проект его отдельную схему и программу проверки. Это важно уточнить до закупки второго канала.
Как работать с сервисом, которому нужен фиксированный IP?
Уточните требование владельца приложения. Банк, партнёрский ресурс или внешняя система могут разрешать доступ только с определённых адресов. При резерве нужно заранее согласовать допустимый второй адрес или другую подходящую схему. Новый маршрутизатор не способен сам изменить политику внешнего сервиса.
Проверьте публикацию входящих сервисов: она может зависеть от адреса и настроек каждого провайдера. Простое резервирование исходящего интернета не гарантирует восстановление входящего доступа. Две задачи полезно показать отдельными строками проекта, чтобы не обещать больше, чем испытано.
Что происходит с DNS и VPN при смене канала?
DNS должен оставаться доступным в резервном режиме. Если используется ресурс, доступный только через основной путь, интернет после failover может существовать по IP, но не открываться по именам. Проверьте фактический DNS-путь и выбранные серверы. Наличие двух WAN не создаёт резерв DNS автоматически.
Для site-to-site VPN согласуйте внешние адреса, идентификаторы и поддерживаемую схему переключения на обоих концах. Удалённая сторона должна принять новое соединение в предусмотренном режиме. Для удалённых сотрудников также проверяют доступность выбранного входа. После смены WAN статус нового туннеля сопоставляют с восстановлением приложения.
Как учитывать скорость и нагрузку резерва?
Резервный канал может быть существенно медленнее основного. Определите, какие процессы должны продолжаться: кассы, 1С, почта, VPN и телефония. Фоновое резервное копирование и обновления способны занять всю полосу и помешать критичным задачам. Предусмотрите ограничения и приоритеты аварийного режима.
Для условной площадки основной канал 200 Мбит/с, резерв 30 Мбит/с. Если критичные приложения в пике требуют 18 Мбит/с, остальные задачи должны укладываться в оставшуюся полосу с учётом запаса и колебаний резерва. Наличие 30 Мбит/с в одном тесте LTE не доказывает такую же скорость каждый вечер.
Как рассчитать режим работы на LTE-резерве?
Определите обязательные и откладываемые приложения. В учебной модели десять голосовых сессий требуют суммарно 1 Мбит/с, а шесть облачных рабочих сессий — 4,8 Мбит/с. Общая принятая полезная нагрузка — 5,8 Мбит/с. С условным запасом 30% ориентир равен 7,54 Мбит/с. Эти параметры не являются нормой для приложений или гарантией LTE.
Если совокупный поток 5,8 Мбит/с непрерывно держится шесть часов, объём составит 5,8 / 8 × 21 600 / 1000 = 15,66 ГБ в десятичных единицах. С выбранным запасом 30% — около 20,36 ГБ. В реальности активность меняется, а учёт тарифа и направления нужно проверить. Расчёт задаёт верхнюю учебную модель заданного постоянного режима, а не прогноз расхода объекта.
Для резерва проверьте исходящую скорость и устойчивость в часы, когда основной канал может потребоваться заменить. Утренний тест пустой базовой станции не подтверждает вечерний результат. Также предусмотрите ограничения обновлений, резервного копирования и необязательных передач в согласованной политике. Выделенная обязательная группа должна работать при принятой нагрузке.
Как не перегрузить резерв в момент переключения?
Разделите сервисы на необходимые в аварии и откладываемые. Если резервный канал намного слабее, ночная выгрузка или массовое обновление может занять его прежде, чем сотрудники восстановят рабочие сессии. Приоритеты и ограничения должны быть подготовлены до аварии и проверены на выбранной модели. Название QoS не означает автоматического знания, какая задача вашей компании важнее.
После восстановления основного канала контролируйте возврат новых соединений и поведение существующих. Немедленная попытка возвращать все сессии может создавать дополнительные обрывы; длительное сохранение их на резерве расходует ограниченный трафик. Поддержка привязки соединений и условия изменения маршрута зависят от платформы. В приёмке отдельно запишите потерю основного пути, работающий резерв, возврат основного и конечное состояние. Проект считается проверенным, когда сервис доступен в согласованной нагрузке на обоих этапах, а не только когда интерфейс перестал показывать Down.
Какой резерв выбирать при росте бизнеса?
Сопоставьте будущие критичные приложения и реальную полосу запасного канала. Резерв 20 Мбит/с может быть достаточен для одной небольшой площадки и недостаточен после появления нового отдела. Запас по скорости и независимость трассы — разные параметры. Отдельно проверьте шлюз при включённых политиках и VPN, чтобы резервный путь не столкнулся с новым внутренним ограничением.
Сколько мобильного трафика потребует резерв?
Если полезная средняя нагрузка составляет 10 Мбит/с в течение восьми часов, арифметический объём равен 10 / 8 × 28 800 = 36 000 МБ, то есть 36 ГБ в десятичном определении единиц. Накладные расходы и фоновые процессы могут добавить трафик. Это расчёт по принятой средней нагрузке, а не прогноз расхода любой компании.
Заранее задайте уведомление о переходе на мобильный WAN, лимиты и ответственного. Без уведомления офис может неделями работать на платном резерве после незамеченного отказа основной линии. Проверяйте возврат и восстановление штатной политики.
Как избежать скрытого расхода резерва?
Настройте доступные уведомления и контроль объёма, затем испытайте их. Дополнительно определите, какие задачи запрещаются или ограничиваются на мобильной линии. Большая загрузка обновлений способна быстро потратить лимит и ухудшить важные приложения. Политика аварийного режима должна быть понятна пользователям и администраторам.
Регистрируйте продолжительность работы на резерве и причину отсутствия возврата. Если основная линия исправна, а шлюз всё ещё считает её недоступной, исследуйте health check и правила. Обращение к оператору лучше сопровождать временем, адресами проверки и результатами, чем общей жалобой на интернет.
Как организовать возврат на основной канал?
Слишком быстрый возврат при нестабильной линии вызывает повторные переключения. Используйте поддерживаемую задержку или критерий устойчивого восстановления и проверьте новые и старые сессии. Не все шлюзы возвращают существующие соединения одинаково: поведение зависит от реализации и правил.
В журнале должны быть время отказа, причина, выбранный WAN и время восстановления. Это позволяет отделить проблему провайдера от ложного health check. Сохраняйте статистику и сверяйте её с жалобами приложений.
Как возвращаться на основной канал без частых переключений?
Добавьте предусмотренное подтверждение устойчивого восстановления, если реализация позволяет его задать. Один успешный ответ после аварии не всегда означает стабильный основной путь. В учебной модели семь успешных проверок с интервалом пять секунд охватывают около тридцати секунд между первой и последней. Конкретный таймер и метод возврата выбирают по возможностям системы.
Поведение активных сессий при возврате также проверяют отдельно. В некоторых поддерживаемых схемах новые соединения могут уходить в основной WAN, а существующие сохраняют свой путь; в других порядок отличается. Сохранение и завершение сессий должно быть ожидаемым. Возврат, который резко прерывает всё рабочее приложение, может не соответствовать требованиям, даже если основной канал снова доступен.
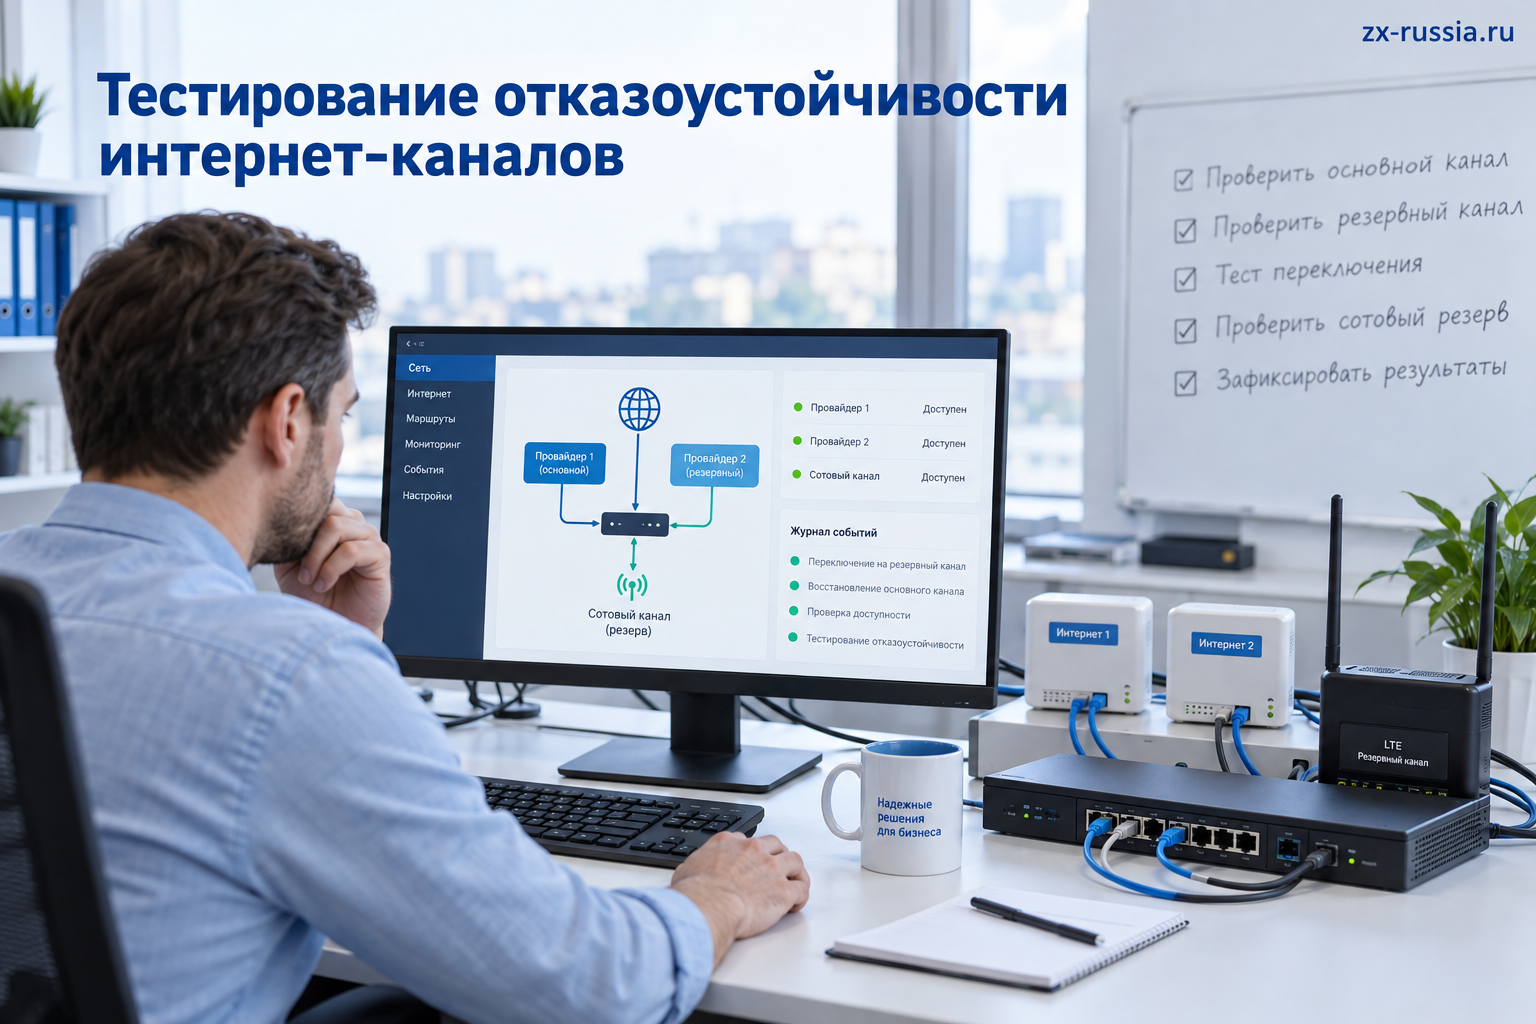
Как испытать два провайдера до приёмки?
- Проверьте отключение кабеля основного WAN.
- Смоделируйте ситуацию с работающим портом, но недоступным внешним путём.
- Испытайте отказ контрольного адреса, если это возможно без влияния на рабочую сеть.
- Проверьте 1С, VPN, звонок и новые HTTPS-соединения на резерве.
- Измерьте скорость при типичной аварийной нагрузке.
- Верните основной канал и проверьте устойчивый возврат.
- Убедитесь, что администратор получает уведомления.
Не выполняйте опасное отключение рабочего канала без согласованного окна. Для пилота используйте тестовую нагрузку и заранее заданный план возврата. Протокол приёмки должен описывать фактическое поведение приложений, а не только зелёные индикаторы портов.
Как проверить, что резервный канал действительно используется?
После предусмотренного отказа посмотрите активный маршрут, счётчики соответствующего WAN и внешний адрес новой сессии. Не полагайтесь только на индикатор второго порта. Устройство может иметь физическую связь, но не выбранный путь. При этом разные приложения могут использовать разные правила, поэтому проверяйте те, которые важны компании.
Запустите новую контрольную сессию и отдельно сохраните результат старой. Такая проверка показывает разницу между продолжением доступа и сохранением соединения. Если новая сессия работает, а существующий звонок оборвался, резерв может выполнять согласованную задачу, но условие безразрывного звонка не выполнено. Оба результата должны быть отражены в акте.
| Этап отказа | Что измерить | Что показывает |
|---|---|---|
| Обнаружение | Время перехода состояния WAN | Работу проверки доступности |
| Выбор пути | Маршрут и новый внешний адрес | Фактическое использование резерва |
| Приложение | Отклик и повторный вход | Полезное восстановление сервиса |
| Возврат | Устойчивость основного пути | Отсутствие повторных колебаний |
Почему нельзя проверять только отключение кабеля?
Физический обрыв — один из простых сценариев. Но у провайдера может пропасть связь за его устройством, сохранив активный Ethernet-порт в офисе. Поэтому детектор должен проверять нужный путь, а программа испытания — воспроизводить предусмотренные виды недоступности. Наблюдение зелёного Link не доказывает доступность интернета.
При этом остановка одного внешнего контрольного сервера не всегда равна отказу провайдера. Выбранные проверки должны помогать отличить эти ситуации. Если возможны несколько проверок и условие их оценки, документируйте правило. Нельзя считать частые автоматические переключения нормальным резервом без исследования причины.
Как проверить аварии, при которых Ethernet остаётся Up?
Самый простой тест — вытащить кабель — проверяет потерю физического соединения. Но провайдерский сбой может оставить Ethernet активным: доступен ближайший узел, а внешние приложения не отвечают. Испытайте этот класс отказа отдельной контролируемой процедурой. Для лаборатории можно ограничить выбранный внешний путь без отключения локального линка, сохранив возможность вернуть исходное состояние. На рабочем объекте способ моделирования согласуют, чтобы не перекрыть одновременно управление и путь отката.
Если проверка канала обращается к адресу, маршрут которого автоматически ушёл через второй WAN, она может показать ложную исправность первого. Контроль должен быть связан с проверяемым интерфейсом так, как это поддерживает выбранная модель. Для каждого WAN запишите источник, назначение и способ определения успеха. Проверьте фактический путь probe, а не только наличие его имени в настройке. Это особенно важно при общей таблице маршрутов и нескольких доступных next-hop.
Один внешний адрес может перестать отвечать независимо от провайдера. Несколько адресов уменьшают зависимость от одной конечной точки, но требуют ясной логики ANY/ALL и поддерживаемого типа проверки. Если все probes используют один внешний DNS, его отказ может влиять на результат сразу нескольких тестов. Не называйте два доменных имени независимыми, не разобрав их общий механизм разрешения и маршрут.
Затем проверьте прикладной результат. Новая HTTPS-сессия должна открыться через резерв, действующая сессия может потребовать повторного установления. Для VPN нужно восстановление предусмотренного туннеля, для внешней публикации — достижимость соответствующего адреса. Эти сценарии не объединяются одним успешным тестом скорости. У компании может сохраняться исходящий интернет и одновременно исчезнуть приём входящих соединений на адрес основного провайдера.
Как документировать ложное переключение?
Сохраните время, результаты health check, состояние физического порта и фактическую доступность нескольких нужных ресурсов. Сопоставьте событие с действиями провайдера и самого шлюза. Если приложение работало, а контрольный адрес перестал отвечать, исследуйте критерий отказа. Не увеличивайте таймеры вслепую: это может скрыть ложную тревогу и одновременно замедлить реакцию на настоящий отказ. Повторите предусмотренные сценарии после изменения. Повторные переключения фиксируйте в отдельном журнале с причиной и временем.
Что подобрать из Zyxel?
В каталоге маршрутизаторов и межсетевых экранов проверьте WAN-порты, health check, политики и VPN. Для мобильного резерва можно включить в проверку FWA510, сверив режимы, диапазоны и условия подключения. Название Dual-WAN не заменяет проверку нужных функций на точной модели.
Частые вопросы о двух провайдерах
Два канала суммируют скорость одного файла?
Обычно распределяются разные соединения. Для суммирования одного потока нужны специальные поддерживаемые механизмы всей цепочки. Не считайте обычную балансировку эквивалентом такой услуги.
При переключении ничего не прервётся?
Существующие сессии могут прерваться из-за нового адреса и маршрута. Проверяйте нужные приложения и согласуйте допустимое время восстановления.
LTE всегда подходит как резерв?
Только после проверки покрытия, нагрузки оператора, ограничений SIM, питания и требований VPN. Для объекта с плохим сигналом сначала решают радиочасть.
Что отправить для расчёта?
Провайдеров, скорости, типы адресов, приложения, допустимый перерыв и лимит мобильного трафика. Через запрос КП передайте сценарии отказа, чтобы подобрать шлюз и резерв с нужным поведением.